移动机器人自主导航与探索:从输入到输出的全过程
移动机器人自主导航与探索,本质上是把传感器原始数据逐步变成电机速度指令的一条分层流水线。
一句话概括:
输入:激光/相机/IMU/里程计 + 初始位姿 + 任务目标(探索时目标由机器人自己生成) 输出:全局路径 → 局部轨迹 → 速度指令 ((v,\omega)) → 左右轮速/转向角
目录
一、总流水线
传感器原始数据
   ↓ 预处理、时间同步、坐标变换
状态估计(定位)→ 位姿 (x, y, θ)
   ↓
建图 / 代价地图(栅格、障碍、膨胀层)
   ↓
探索决策(未知环境才需要)→ 下一个目标点
   ↓
全局路径规划 → 全局路径(折线/路径点)
   ↓
局部路径规划 → 局部轨迹(带时间/速度)
   ↓
轨迹跟踪与控制 → (v, ω) / 转向角 / 轮速
   ↓
电机执行 → 机器人运动
   ↑________________ 传感器反馈闭环 ________________|
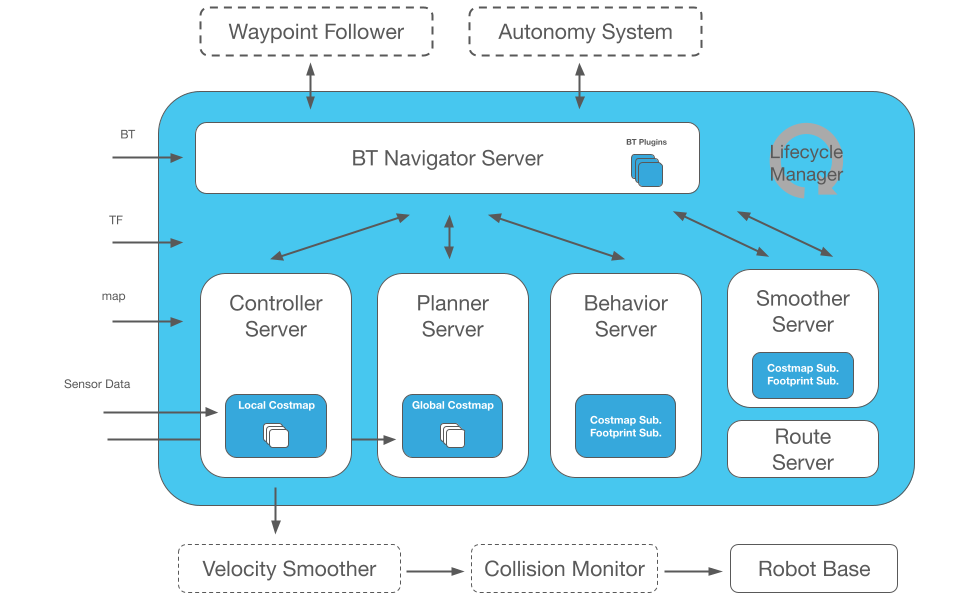
图 1:Nav2 导航系统架构。可以看到 Controller Server、Planner Server、Behavior Server、Smoother Server 等模块,以及 Local Costmap / Global Costmap 的分工。(来源:Nav2 官方文档)
各阶段输入、输出与算法一览
| 阶段 | 输入 | 输出 | 典型算法 | 频率 |
|---|---|---|---|---|
| 1. 感知预处理 | 激光点云、RGB/深度图、IMU、轮速计 | 去畸变、滤波后的点云/特征、同步后的里程计 | 体素滤波、地面分割、TF 变换 | 10–100 Hz |
| 2. 状态估计(定位) | 里程计、IMU、激光/视觉观测、已有地图 | 机器人在map系下的位姿((x,y,\theta))及协方差 |
EKF/UKF、AMCL 粒子滤波、图优化 SLAM(Cartographer、FAST-LIO、ORB-SLAM) | 10–50 Hz |
| 3. 建图与代价地图 | 位姿 + 点云 | 占据栅格地图、代价地图(静态层/障碍层/膨胀层)、ESDF | 占据栅格、TSDF、八叉树 | 1–10 Hz |
| 4. 探索决策(未知环境) | 当前地图、已探索区域、机器人位姿 | 下一个探索目标点/子目标 | Frontier-based、Next-Best-View、信息增益/熵、TARE、GBPlanner | 0.5–2 Hz |
| 5. 全局规划 | 地图、起点、目标点、机器人 footprint | 全局路径(离散路径点或 cost-to-go 场) | Dijkstra、A*、JPS、D*、RRT/RRT*、蚁群、动态规划 | 事件触发(新目标/地图大变化) |
| 6. 局部规划 | 全局路径、局部代价地图、当前位姿/速度、动态障碍 | 局部轨迹(位姿序列 + 时间/速度)或直接给速度 | DWA、VFH/VFH+、TEB、人工势场、贝塞尔/B 样条、MPC | 5–20 Hz |
| 7. 轨迹跟踪 | 参考轨迹、当前状态 | 期望线速度(v)、角速度(\omega)/ 转向角 | Pure Pursuit、Stanley、LQR、PID、MPC | 20–100 Hz |
| 8. 底层控制 | 期望(v,\omega) | 左右轮速、电机电流/力矩 | 轮速 PID、电流环、伺服 | 100–1000 Hz |
二、逐层拆解
1. 感知预处理
机器人首先要知道周围有什么。常见传感器:
- 2D/3D 激光雷达:测距精度高,适合建图、定位、避障;
- 深度相机 / 双目 / RGB-D:有语义和纹理信息,适合视觉 SLAM、障碍物分类;
- IMU:提供角速度和加速度,弥补轮速计在打滑、颠簸时的误差;
- 轮式里程计:短时平滑,但会累积漂移;
- GNSS:室外全局定位,室内通常不可用;
- 超声波/红外/防跌落传感器:近距安全兜底。
这一层做的是“把原始数据变成可用数据”:
- 时间同步(激光、图像、IMU 的时间戳对齐);
- 去畸变、滤波、降采样(体素栅格、统计滤波);
- 坐标变换(
base_link → laser、base_link → camera); - 地面分割、聚类、特征提取。
输出:统一坐标系下、带时间戳的点云/图像/特征/里程计。
2. 状态估计(定位)
机器人必须知道“我在哪”。输入是里程计(短期准、长期漂移)和激光/视觉观测(长期准、短期可能跳变),融合后输出 map → odom → base_link 的坐标变换。
- 有地图:AMCL/NDT 把当前扫描与地图匹配,得到全局位姿;
- 无地图:SLAM 同时估计位姿并建图,输出地图 + 轨迹;
- 多传感器融合:EKF/UKF、因子图优化(如 LIO-SAM、FAST-LIO、Cartographer)。
定位一旦丢失( kidnapped robot、长走廊、玻璃幕墙、动态人群),后面的规划全部失效,所以工程上通常有重定位、多传感器冗余和置信度监控。
输出:机器人在 map 坐标系下的位姿 ((x,y,\theta)) 及协方差。
3. 建图与代价地图
3.1 占据栅格地图
把环境离散成网格,每格用概率表示“被占据”的程度:
- Free(空闲):可以通行;
- Occupied(占据):障碍物;
- Unknown(未知):还没观测到。

图 2:占据栅格地图中的空闲栅格、占用栅格与未知栅格。(来源:CSDN《激光SLAM中的占据栅格地图构建算法详解》)
激光 SLAM 通常用 log-odds 做贝叶斯更新:
[L(x) = \log\frac{p(x)}{1-p(x)}, \qquadL(x) \leftarrow L(x) + L*{\text{occ}} \quad \text{或} \quad L(x) \leftarrow L(x) + L*{\text{free}}]
3.2 代价地图(Costmap)
原始栅格只有“占用/空闲/未知”,规划器还需要一张“走哪里代价低”的地图。代价地图通常由多层叠加:
- Static Layer:先验地图或 SLAM 地图;
- Obstacle Layer:激光/深度图实时写入障碍;
- Voxel Layer:3D 点云投影;
- Inflation Layer:按机器人半径 + 安全距离把障碍“膨胀”,让路径远离墙壁;
- Unknown Layer:探索时标记未探索区域。

图 3:代价地图的膨胀层。障碍附近代价高,随距离按指数衰减;inscribed radius 内必定碰撞,inflation radius 外代价为 0。(来源:ROS Wiki costmap_2d)
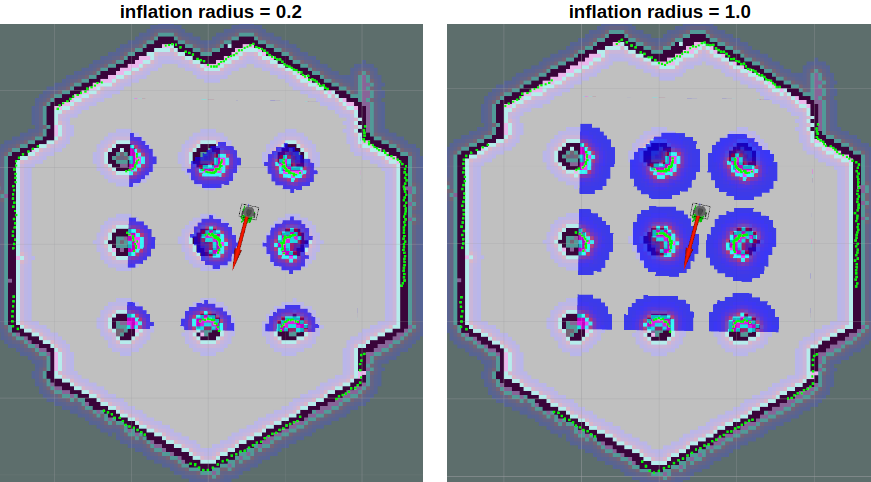
图 4:inflation_radius 较小时(左)机器人可以贴着障碍走;较大时(右)路径更保守,但窄通道可能被堵死。(来源:Nav2 文档)
输出:全局/局部代价地图、ESDF(欧氏符号距离场)等。
4. 探索决策(未知环境)
导航是“目标已知,规划过去”;探索是“目标未知,自己找目标”。核心概念是 Frontier(边界):
free 区域与 unknown 区域的交界线,就是还有未知空间可以探索的地方。

图 5:栅格地图中的 Occupied / Unknown / Free 三类栅格,以及带方向的 Frontier。箭头表示从已知区域看向未知区域的方向;图中以无人机为例,栅格概念同样适用于地面机器人。(来源:Sensors 2020, 20(22), 6507,CC BY 4.0)
典型的 frontier 探索流程:
- 在地图上提取所有 frontier;
- 对 frontier 聚类,过滤掉太小的边界;
- 对每个候选点计算代价:
- 信息增益:能探索到多少未知区域;
- 路径代价:走过去要多久、是否安全;
- 回环/重复探索惩罚;
- 朝向/传感器视野(Next-Best-View)。
- 选一个最优目标,交给全局规划器;
- 到达后地图更新,产生新 frontier,循环;
- 没有 frontier 或覆盖率达到阈值 → 探索结束,返回起点/指定点。
常见方法:
- Frontier-based Exploration(Yamauchi 1997);
- Next-Best-View / 信息熵:选“最能减少不确定性”的观测点;
- TARE、GBPlanner、DSV Planner:大规模未知环境的分层探索;
- 强化学习探索:用策略网络直接输出下一步目标。
输出:下一个探索目标点/子目标。探索的外层循环频率很低(秒级),因为它依赖地图的显著更新。
5. 全局路径规划
输入:地图/代价地图、起点、目标点、机器人 footprint。 输出:全局路径(离散路径点/折线),或 cost-to-go 场。 频率:事件触发(新目标、地图大幅变化)。
常见算法:
- Dijkstra:保证最优,但盲目扩展,适合小图/教学;
- A*:启发式搜索,工程上最常用;
- JPS:在均匀栅格上跳过冗余节点,加速 A*;
- D*:动态环境/未知环境重规划;
- RRT / RRT*:采样规划,适合高维、复杂约束;
- 蚁群、动态规划:特定场景的全局优化。

图 6:A* 的典型问题设置:绿色为起点,红色为目标,蓝色为障碍区域。(来源:CSDN @CHH3213)

图 7:A* 在栅格上扩展节点,格子中的数字是 (f=g+h)。A* 每次优先扩展 (f) 最小的节点,因此比 Dijkstra 更有方向性。(来源:CSDN @CHH3213)

图 8:RRT 在障碍环境中不断随机采样、扩展,形成一棵覆盖自由空间的树。(来源:CSDN @weixin_48927787)

图 9:RRT 的核心步骤:随机采样 (X{rand}),找到树上最近点 (X{near}),沿方向扩展步长得到 (X_{new}),并做碰撞检测。(来源:CSDN @weixin_48927787)
6. 局部路径规划
输入:全局路径、局部代价地图、当前位姿/速度、动态障碍。 输出:局部轨迹(位姿序列 + 时间/速度)或直接给速度。 频率:5–20 Hz。
常见算法:
- DWA(动态窗口法):在速度空间 ((v,\omega)) 采样,前向模拟轨迹,按“贴近全局路径 + 远离障碍 + 速度大”打分;
- VFH/VFH+:把障碍投影到极坐标直方图,选可通行方向;
- TEB(时间弹性带):把轨迹建模成带时间信息的弹性带,用优化器求解;
- 人工势场法:目标吸引 + 障碍排斥,简单但易陷局部极小;
- 贝塞尔/B 样条:生成平滑、满足曲率约束的曲线;
- MPC:带动力学约束的滚动优化。

图 10:DWA 流程:采样速度 → 生成模拟轨迹 → 轨迹评价 → 遇到障碍则重新采样 → 选择最优轨迹。(来源:CSDN @CHH3213)

图 11:DWA 根据当前位姿和候选速度预测轨迹终点,并结合目标方向、障碍距离、速度等指标评价。(来源:CSDN @CHH3213)
全局 vs 局部:全局给“大致怎么走”,局部给“这一刻怎么打方向盘”。全局规划强调最优/完备,局部规划强调实时/安全。
7. 轨迹跟踪与控制
规划输出的是几何路径或轨迹,真正驱动电机的是速度:
- Pure Pursuit(纯跟踪):在路径上取一个前视点,算圆弧曲率:
[\kappa = \frac{2\sin\alpha}{L_d}, \qquad \omega = v\kappa]
其中 (L_d) 是前视距离,(\alpha) 是前视点相对车头的夹角。
- Stanley:用前轮中心到路径的横向误差 (e) 和航向误差 (\psi_e) 计算转向角:
[\delta = \psi_e + \arctan\left(\frac{k e}{v}\right)]
- LQR:把跟踪误差建模成状态空间,求最优反馈增益 (u=-Kx);
- PID:简单场景的速度/航向闭环;
- MPC:带约束的滚动优化跟踪。

图 12:Pure Pursuit 的几何关系:车辆当前位置 A、前视点 C、前视距离 (L_d)、圆弧半径 (R) 与夹角 (\alpha)。(来源:CSDN @WaiNgai1999)
输出:期望线速度 (v)、角速度 (\omega) / 转向角。
8. 底层控制与执行
- 轮速 PID:把 ((v,\omega)) 分配到左右轮;
- 电机电流环/伺服:跟踪轮速;
- 编码器、IMU 反馈:形成底层闭环;
- 安全层:急停、限速、防撞、传感器失效检测。
输出:左右轮 PWM/电流/力矩,机器人真正运动。
三、导航闭环 vs 探索闭环
可以把整个系统看成四个时间尺度的闭环:
底层控制环(1–100 ms):电机 → 编码器 → 轮速 PID
局部避障环(50–200 ms):激光 → 局部地图 → DWA/TEB → (v,ω)
全局规划环(秒级/事件):地图 → A*/D* → 全局路径
探索决策环(秒–十秒级):地图 → frontier/NBV → 下一个目标
- 已知地图导航:只有下面三个环,目标是用户给的;
- 未知环境探索:四个环全开,最外层不断“生成新目标”,直到地图覆盖完成。
| 对比项 | 导航(Navigation) | 探索(Exploration) |
|---|---|---|
| 目标 | 用户给定 | 机器人自己生成 |
| 地图 | 已知或部分已知 | 未知,边建图边规划 |
| 核心问题 | 怎么过去 | 去哪里、怎么覆盖 |
| 外层循环 | 无 | frontier/NBV 持续选目标 |
| 结束条件 | 到达目标 | 无 frontier、覆盖率达标、时间/电量限制 |
四、一个具体例子走一遍
差速轮机器人 + 2D 激光雷达,在未知室内环境执行“探索整层楼并回到起点”:
- 开机:初始位姿 ((0,0,0)),地图全 unknown;
- 感知:激光每 100 ms 扫一圈,得到约 360 个距离点;IMU/轮速计给出短时运动;
- 定位与建图:扫描匹配得到位姿,栅格地图把观测到的区域标为 free/occupied;
- 探索决策:提取 frontier,选最近且信息增益最大的一个点作为目标;
- 全局规划:A* 在代价地图上规划到该 frontier;
- 局部规划:DWA 在速度空间采样 ((v,\omega)),前向模拟若干条轨迹,按“贴近全局路径 + 远离障碍 + 速度大”打分,选最优;
- 跟踪控制:Pure Pursuit 把局部轨迹转成 ((v,\omega)),轮速 PID 输出左右轮 PWM;
- 到达 frontier:地图更新,出现新 frontier,回到第 4 步;
- 探索完成:没有 frontier 了,全局规划一条回起点的路径,导航回去;
- 异常处理:途中遇到动态行人 → 局部重规划绕开;走进死胡同 → 全局重规划;被卡住 → 恢复行为(后退/旋转/清除代价地图)。
五、工程上最容易出问题的点
- 坐标系与 TF:
map → odom → base_link → laser必须闭环,时间戳要同步;TF 错一切错。 - 定位漂移/丢失:长走廊、玻璃、动态人群;需要重定位和多传感器融合。
- 代价地图膨胀:膨胀太小会擦碰,太大会把窄通道堵死。
- 局部极小值:人工势场/VFH 在 U 型障碍前容易卡住,需要逃逸策略或全局规划兜底。
- 探索目标震荡:两个 frontier 来回选,需要加滞回/代价平滑。
- 频率匹配:全局规划不能放进高频循环;局部规划不能太慢,否则避障失效。
- 安全兜底:急停、速度限幅、传感器失效检测、地理围栏。
六、与学习文档算法的对应关系
| 流水线环节 | 文档中的算法 |
|---|---|
| 全局规划 | Dijkstra、A*、JPS、D*、RRT/RRT* |
| 局部规划 | DWA、VFH、TEB、人工势场、贝塞尔曲线、B 样条 |
| 轨迹跟踪 | Pure Pursuit、Stanley、LQR |
| 建图/定位 | 文档未覆盖,需补 SLAM(Cartographer、FAST-LIO 等) |
| 探索决策 | 文档未覆盖,需补 Frontier/NBV、TARE、GBPlanner |
建议学习路径:
先全局规划(A*/D*)→ 再局部规划(DWA/TEB)→ 再跟踪控制(Pure Pursuit/Stanley/LQR)→ 最后补 SLAM 与探索决策。
这样正好对应“输入 → 输出”的完整链条。